The SA-FARI Dataset: Segment Anything in Footage of Animals for Recognition and Identification
这篇论文提出了 SA-FARI——目前最大规模的开源野生动物多动物跟踪(Multi-Animal Tracking, MAT)数据集。
野生动物保护依赖自动视频分析,而多动物跟踪(MAT)是其中的基础任务——它支撑个体重识别(re-identification)和行为识别等下游应用。但领域内缺乏合适的基准:规模小、物种单一、时空多样性不足。
数据集核心指标:
- 11,609 个视频,2014–2024 年采集,覆盖 741 个地点、4 大洲;
- ~46 小时密集标注视频,99 个物种类别;
- 16,224 个 masklet 身份(单个个体动物的时空分割轨迹)和942,702 个边界框/分割掩码/物种标签。
masklet:由分割掩码(而非仅有边界框)构成的时序轨迹,是比普通 tracklet 信息量更丰富的标注形式;并且数据附带匿名化的相机陷阱位置。
| Dataset | Sites | Species | Videos | Duration (h) | Tracklets | Segmentation | Source |
|---|---|---|---|---|---|---|---|
| AnimalTrack [51] | — | 10 | 58 | 0.23 | 2k | ✕ | YouTube |
| GMOT [2] † | — | 4 | 16 | 0.03 | 1k | ✕ | YouTube |
| TAO [17] / BURST [1] † | — | 51 | 429 | 3.60 | 1k | ✕/√ | Varied |
| BuckTales [32] | 1 | 1 | 12 | 0.21 | 0.7k | ✕ | UAV |
| BaboonLand [18] | 1 | 1 | 18 | 0.32 | 1k | ✕ | UAV |
| KABR [26] | 1 | 3 | 742 | 10.00 | — | ✕ | UAV |
| WildLive [16] | 1 | 3 | 22 | 0.70 | 0.3k | √ | UAV |
| CCR [4] | 3 | 1 | 27 | 10.00 | 12k | ✕ | Video Camera |
| MammAlps [20] | 3 | 5 | 2,384 | 14.50 | 6k | ✕ | Camera Trap |
| PanAf500 [8] | 12 | 2 | 500 | 2.10 | 1.5k | ✕ | Camera Trap |
| SA-FARI (ours) | 741 | 99 | 11,609 | 45.78 | 16k | √ | Camera Trap |
支持任务列表:
| 层次 | 任务 | SA-FARI 提供的支撑 | 相关标注/指标 |
|---|---|---|---|
| 基础视觉任务 | 目标检测(物种特定 & 物种无关) | 942,702 个边界框 + 物种标签;负样本物种标签用于训练分类精度 | cgF₁、HOTA-Det、TETA-Det |
| 实例分割 | 942,702 个手工校验的分割掩码(唯一大规模人工校验的 MAT 数据集) | 分割质量经 IoU 去重 + 多轮人工修正 | |
| 多动物跟踪(MAT) | 16,224 个带个体身份的 masklet(时空分割轨迹),每视频平均 1.4 个,最多 14 个 | HOTA、IDF1、TETA-Ass | |
| 物种分类 | 99 个物种类别,含俗名、拉丁名、完整分类学层级(纲→目→科→属→种) | 29 个分组用于构造难/易负例 | |
| 高级智能任务 | 个体重识别(Re-ID) | 空间表征(皮毛花纹、体型、姿态)+ 16k 个体级 masklet | 论文指认为下游应用 |
| 行为识别 | 时间动态(步态、运动、社会互动)捕获行为语境 | 论文指认为下游应用 | |
| 开放词汇分割跟踪(提示驱动) | 物种名提示(“fox”)与通用提示(“animal”)两种评测协议(PCS) | cgF₁、pHOTA、TETA | |
| 防捷径学习 / OOD 泛化研究 | 时空表征避免背景线索捷径;分布外场景多样 | 论文论证其泛化价值 | |
| 细分评测场景 | 小目标 / 大目标 | Small-masklet(212 视频)vs Large-masklet(211 视频)子集 | 大小掩码 pHOTA 差 29.2 |
| 遮挡与运动目标 | Challenging 子集(106 视频,运动/≥2 次遮挡) | 相比整体 pHOTA-Ass 低 9.3 | |
| 夜间/低光 | Night 子集(598 视频,IR 红外录像) | 与整体表现接近 | |
| 多动物密集场景 | Multi-masklet 子集(136 视频,≥2 只动物) | 与大掩码正相关,难度适中 |
SoccerMaster: A Vision Foundation Model for Soccer Understanding
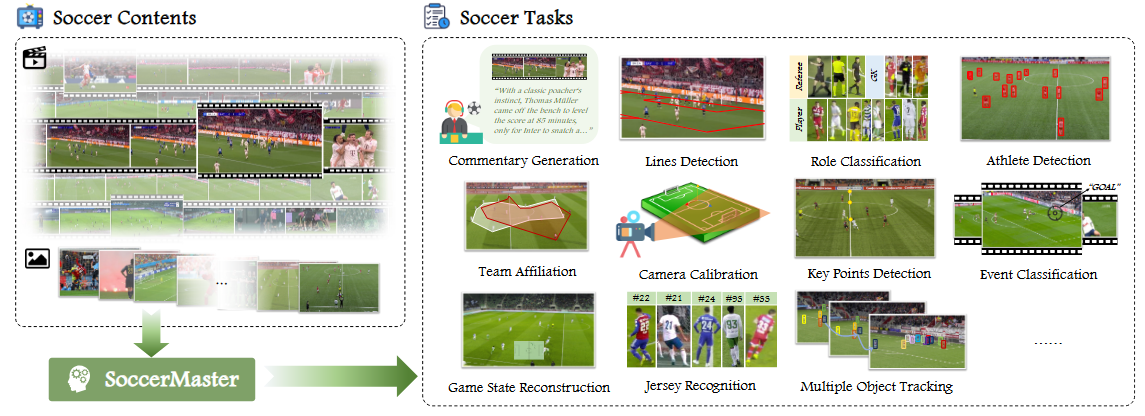
这篇论文目标是构建第一个足球专属的视觉基础模型(Vision Foundation Model),用一个统一框架同时解决足球视频理解中的"空间感知"和"语义推理"两大类任务。
- 提出 SoccerMaster,第一个足球专属视觉基础模型,通过监督式多任务预训练在单一框架内统一多种任务;
- 开发 SoccerFactory 自动化数据整理管线,生成可扩展的空间标注,并整合多个现有足球视频数据集;
- 广泛实验证明 SoccerMaster 在多个下游任务上一致优于任务专用专家模型。
| 任务 | 类型 | 输入 | 输出 | 回答的问题 |
|---|---|---|---|---|
| 运动员检测与识别 | 预训练 | 帧 | 框+角色+号码 | who / where |
| 球场注册 | 预训练 | 帧 | 关键点+线 | where(场地几何) |
| 事件分类 | 预训练 | 视频片段 | 24 类事件标签 | what |
| 视觉-语言对齐 | 预训练 | 视频+文本 | 相似度 | 语义对应 |
| 解说生成 | 下游 | 视频 | 文本解说 | 讲什么 |
| 摄像机标定 | 下游 | 帧 | K, R, t | 3D 几何 |
| 多目标跟踪 | 下游 | 视频 | 轨迹+身份 id | 谁在哪持续出现 |
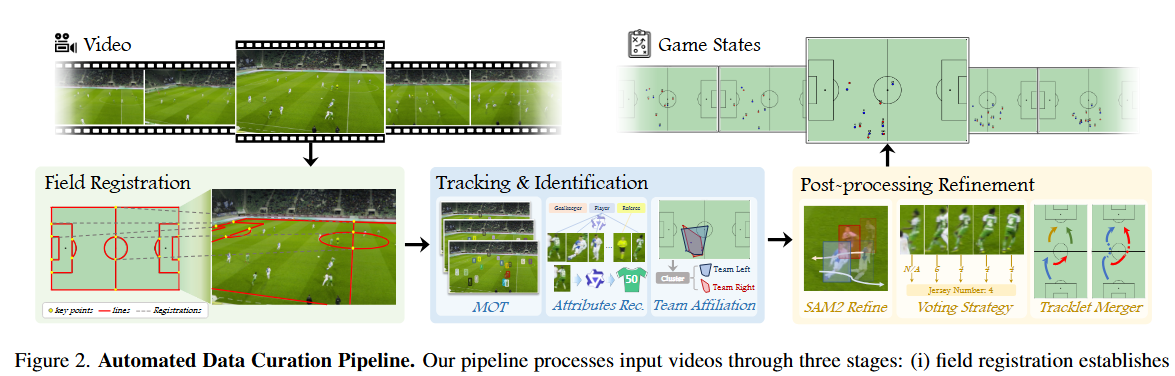
自动化数据集构建pipline: 管线分三个阶段,每个阶段解决一类标注问题:
球场注册:先检测球场关键点和线 → 用 PnL 模块(即 PnLCalib 的优化方法)估计相机参数 → 建立图像与标准球场坐标的投影关系。有了这个投影,还能从标准球场反向投影来精炼检测到的关键点和线,得到更干净的训练标注。球场注册是后续一切空间标注的基础,因为没有它就无法把图像坐标映射到统一的世界坐标。
跟踪与识别:从检测到带身份信息的轨迹跟踪,具体来说,用微调的YOLOV8做运动员检测,Strong-SORT + PRTReID做跟踪,其中 PRTReID 提供 ReID 嵌入用于跨帧身份关联;Qwen2.5-VL对每个检测框识别角色(守门员/球员/裁判)和球衣号码,并用可读性过滤器过滤掉模糊不清的号码识别结果。通过对 tracklet 平均 ReID 嵌入 + 球场坐标做聚类得到团队归属。
后处理Refine:SAM2 分割精炼恢复检测器的漏检、纠正跟踪的身份切换;在 tracklet 内部对球衣号码和角色做时间一致性投票;结合 ReID 嵌入和号码一致性,把碎片化短轨迹合并成长轨迹;
作者还做了数据集质量评估,在 SoccerNet Game State Reconstruction(GSR)挑战赛测试集上评估。
| 任务类别 | 数据集 | 帧数 | 预训练任务 | 标注来源 | 数据处理与说明 |
|---|---|---|---|---|---|
| 空间感知 | SoccerNet-GSR [59] | 42.8K | 运动员检测与识别、球场注册 | 人工标注 | 手工精标数据;tracklet 级球衣号码经 legibility filter 转换为帧级标签,缓解遮挡歧义 |
| 空间感知 | SoccerFactory 生成 | 2.7M | 运动员检测与识别、球场注册 | 自动管线 | 处理 SoccerNet-v2 中 500 场比赛的主镜头片段;排除回放、特写、异机位等视野不全画面;帧与轨迹、相机参数、球场坐标标注齐全 |
| 语义推理 | SoccerNet-v2 [12] | 1.6M | 事件分类 | 现有人工数据集 | 1 FPS 采样 |
| 语义推理 | MatchTime [51] | 7.1K | 事件分类、视觉-语言对齐 | 现有人工数据集 | 1 FPS 采样;文本解说与视频时序对齐 |
| 语义推理 | SoccerReplay-1988 [53] | 3.1M | 事件分类、视觉-语言对齐 | 现有人工数据集 | 1 FPS 采样;覆盖 24 类事件 |
| 研究方向 | 目标运动 | 核心瓶颈 | 数据需求 | 与 SoccerMaster 的衔接 | 可行性 |
|---|---|---|---|---|---|
| 球员级细粒度动作 | 篮球(足球不适用) | 足球场地大、22 人参与度不均,“无关帧/无关球员"占比过高,类别极不均衡,标注信噪比低;篮球 10 人几乎全员围绕球权,标签天然可定义 | 需要逐球员、逐帧动作标注 | 检测头 + 球场注册头迁移到篮球场景,替换为篮球场地模型 | ✅ 顺滑,但需新数据集 |
| 战术分析生成(球员级叙述) | 篮球 | 同球员级动作,依赖逐人标签 | 球员级动作标签 | 同上 | ✅ 顺滑 |
| 战术分析生成(团队级空间分析) | 足球(推翻你最初的判断) | 不需要逐球员动作标签,只需轨迹+坐标+事件;无球端 8 人如何站位正是分析对象,“非全员参与"反而让空间控制分析更有价值 | 不需要新数据——SoccerMaster GSR 输出(球员轨迹、球场坐标、相机矩阵、事件)直接可用 | SoccerFactory / GSR 头天然产出全部输入信号 | ✅✅ 最顺,论文内已有全部组件 |
| 知识型解说 | 足球 / 篮球通用 | 需要"视频+知识+解说"三元组对齐数据集(如 GOAL 的球员档案、比分、历史交锋) | 现有 MatchTime 不含外部知识,需构建或借用知识增强解说数据集 | 对齐头 → Q-Former → LLM 管线可直接升级 | ⚠️ 受数据制约 |
| 集锦自动生成 | 足球 / 篮球通用 | 需要"事件→精彩度评分→剪辑→解说"的端到端数据 | 需要含人工剪辑和评分的比赛数据集 | 事件分类 + 检测 + 跟踪 + 解说四件套串联 | ⚠️ 受数据制约 |
| 多运动基础模型(SportsMaster) | 多运动 | 工作量巨大:每项运动需各自的场地模型、关键点定义、检测类别;跨运动共享表征的收益需要验证 | 需要整合篮球、网球、冰球等多项运动数据集 | 把 SoccerMaster 的多任务预训练配方整体迁移 | ❌ 格局最大,但投入/风险最高 |