论文想解决的问题
这篇论文是针对primitive base的3d重建方法中的高保真和高效率的trade off问题。首先primitive base的3d重建方法是将复杂几何蒸馏为紧凑、可解释、可编辑的解析组件。论文分析这种trade off问题的原因有两个:
1.常用基元族(立方体、超二次曲面、椭球体)表达力有限,需要大量实例才能覆盖丰富的形状变化
2.推理过程本身有缺陷——依赖固定分割的方法(analysis-driven)对分割错误敏感,而纯优化方法(optimization-driven)必须穿越高度非凸的损失景观。
解决思路
没看过这个领域,所以介绍一下相关工作:
基元推理方式:论文把已有方法分为三类,第一类形状分析驱动-先用几何数据将形状分割为区域,再往每个区域里拟合图元。先分割再定图元,分割定死之后,导致和图元并不完全适配。第二类是优化驱动-直接优化整图的图元参数拟合误差,比较依赖好的初始化。第三类是学习驱动方法(deeplearning),学习驱动的问题就是泛化问题,关联性学习的问题。
基于的表示方式:
图元族 代表 优点 缺陷 立方体/圆柱 [8, 36] 可解释、易编辑 表达力太弱 超二次曲面 (Superquadrics) [2, 7, 26] 形状空间更广 牺牲可编辑性,且无法精确表示立方体、锥体等常见实体 代数曲面 (Algebraic surfaces) [43] 表达力强 不可编辑 广义圆柱 (Generalized cylinders) [31, 47] 更灵活 重建保真度仍不足 神经隐式部件 [8, 9, 27, 42] 表达力最高 黑箱、昂贵、难以控制与复用 论文建立了一个可微的八参数可变形的模型SuperFrustum,可变形针对常用基元簇表达力有限的问题,可微+ResFit针对的是先分割再拟合的误差累积。
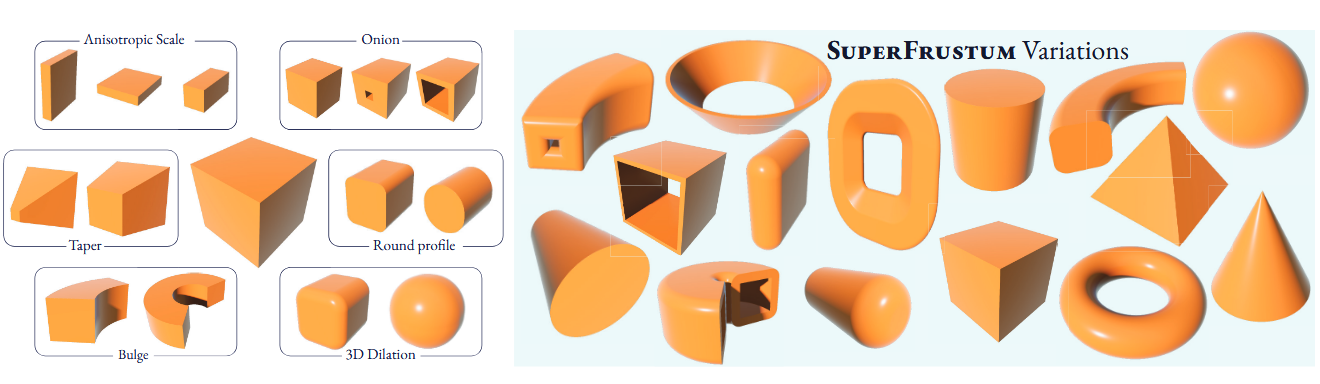
核心方法
问题定义:任务的输出是一个 3D shape,比如生成模型的 SDF 网格,输出是一组解析基元,这些基于通过组合算子可以合成一个闭合曲面 $ E(z) $.
优化目标为:
$$ z^∗=argmax_R(x,E(z))−α|z|$$第一项为重建误差,第二项为复杂度惩罚
ResFit:Residual Primitive Fitting
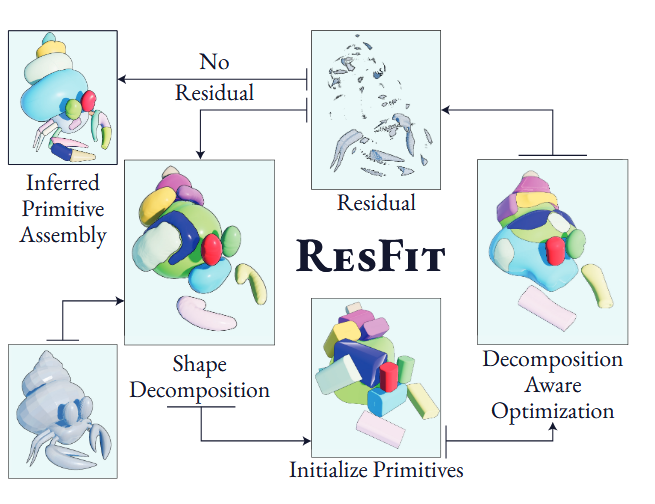
纯优化方法(自下而上)容易让图元纠缠在一起,而纯分析方法(自上而下)在分割形状时根本不考虑所用图元族到底能表达什么。分析派先做几何分割(分割对了,图元未必拟合得好;分割错了,误差就固化下来),优化派只盯着损失函数往下走(可能为了保真堆出大量重叠图元,却毫无结构可言)。ResFit 的解法是让这两者交替进行、互相喂信息。
三个过程,分析(初始化),优化(拟合),残差提取(提取已经被基元覆盖的目标并扣除),迭代直到目标函数不再上升。为了防止基元过多,每轮只播种少量的图元并在优化的时候使用软正则项,最后使用离散剪枝。为了防止欠参数化漏掉细节,保证新图元只基于局部支撑区域优化,每加入新图元之后,整个程序会重新优化一遍。
假设要用一个可膨胀、可弯曲、可抽壳的"橡皮泥积木"去复刻一个茶壶,而且希望积木数量越少越好。
ResFit 的做法很像一个有经验的雕塑师:
先雕最粗的壶身 → 看看哪里还空着 → 补一个积木填壶嘴 → 回头看壶身刚才是不是为了抢壶嘴的体积而变形了,顺手把它改回来 → 再补壶把 → 再改回来……
每一步只解决"当前最显眼的缺口",但每加一个新部件,都会回头重新调整旧部件。这就是 ResFit 的全部哲学。
假设输入是一个茶壶的 SDF(符号距离场),目标是用 SuperFrustum 图元拼出它,跑最多 $K=10$ 轮。
第 0 轮(起点)
- 分析:用 MSD(形态学形状分解)对整个茶壶分解。“按厚度剥皮”——先找最厚的连通区域,这里是壶身(最粗的部分)。
- 播种:从壶身这个体积区域里实例化 1 个 SuperFrustum。用 PCA 估姿态(壶身是竖直的还是倾斜的)、估缩放。
- 优化:梯度下降调整这个图元的 8 个参数 + 姿态,让它贴合壶身体积。
- 算残差:壶身被解释掉了,把茶壶形状减去壶身,剩下的体积 = 壶嘴 + 壶把 + 壶盖 + 壶钮。
第 1 轮
- 分析:对残差(不再是整壶)再做 MSD。此时最厚的区是壶嘴(比壶把粗)。
- 播种:从壶嘴区域实例化第 2 个图元。
- 优化:注意——不是只调新图元,而是把"壶身 + 壶嘴"两个图元一起重新优化。为什么要重调老的?因为第 0 轮没有壶嘴图元时,壶身图元很可能为了覆盖壶嘴根部的体积,把自己拉长了一截。现在有了专门的壶嘴图元,壶身应该缩回去——这就是论文说的 “the full assembly is re-optimized in each round”(每轮重新优化整个装配)的意义所在。
- 算残差:剩下的 = 壶把 + 壶盖 + 壶钮。
第 2 轮
- 分析:残差里最厚的是壶把。但壶把是弯曲的、且粗细不均匀——没关系,SuperFrustum 自带 taper(锥度)和 bend(弯曲)自由度,一个图元就能表达(图 4 里自行车轮胎、猫尾巴就是例子)。
- 播种:实例化第 3 个图元。
- 优化:三个图元一起重调,旧图元再次被纠正。
- 算残差:剩下壶盖、壶钮、以及壶把和壶身连接处少许没解释干净的缝隙。
第 3、4 轮……
继续处理壶盖、壶钮。直到某一轮发现 $O(x,z) = R - \alpha|z|$ 不再上升(加新图元的收益小于 $\alpha$ 的惩罚),循环停止,不再加图元。
如果换成一次性把所有图元从零联合优化(论文在 Table 3 里称其为 Single-shot),一开始 MSD 把茶壶切成了 8 块,8 个图元同时从随机初始位置出发爬山。损失曲面极其崎岖,梯度下降很容易把好几个图元都推去覆盖最大的壶身,谁也不愿出来负责壶把——因为谁离开壶身,谁的局部损失立刻升高,尽管全局解(一个负责壶身、一个负责壶把)更好。这就是"纠缠"(entanglement)的根源。ResFit 用"每轮只加少数图元 + 残差驱动"把一个大而难的优化拆成了好多轮小而简单的优化。
Expressive, Editable & Optimizable Primitive(SuperFrusta)
一个理想的逆向图形基元必须具有足够的表达能力,可以通过直观的控制进行编辑,并且可优化(可微)。
SuperFrustum 被定义为一个解析有向距离场(SDF)的零水平集:
$$SF(p) = f(p; \theta), \quad \theta = (s, r, d, t, b, o)$$| 参数 | 名称 | 作用 |
|---|---|---|
| $s$ | 各向异性缩放(anisotropic scale) | 控制三个轴向的长度比例,使基元能拉长为扁板、细棒等形态 |
| $r$ | 轮廓圆度(profile rounding) | 在尖锐棱边与圆润轮廓之间连续过渡 |
| $d$ | 膨胀(dilation) | 整体"鼓起来"或收缩 |
| $t$ | 锥度(taper) | 沿轴向渐变粗细,形成锥形 |
| $b$ | 凸度(bulge) | 产生中间鼓出的弯曲轮廓 |
| $o$ | 洋葱/壳厚度(onion/shell thickness) | 形成中空、管状等"减法"形态 |
可微:场函数在形状内部连续,梯度除少数棱边/顶点外处处存在,因此可以安全地进行梯度下降;方体、圆柱、圆锥、圆环这些在传统基元族中分属不同类别的形状,在这里只是同一公式的不同参数取值,避免了"多类型基元"需要离散切换类型的优化难题;几乎处处可微;
基元如何组装成完整形状:每个基元实例i带有姿态(旋转,平移)和上述形状参数,单个的SDF为:
$$g_i(p) = f\big(R_i^\top (p - t_i); \theta_i\big)$$整个的SDF通过递归调用平滑并集算子U构造:
$$F_1(p) = g_1(p), \quad F_{k+1}(p) = U\big(F_k(p), g_{k+1}(p); \beta_k\big)$$$\beta_k$用于控制两个基元的混合强度。
服务于SuperFrusta的形状分解
分解是为了为ResFit的过程提供初始基元,包括初始化和残差部分的基元。
选用形态学形状分解(Morphological Shape Decomposition, MSD),而不是形态学形状分解(Morphological Shape Decomposition, MSD),作者的解释如下:
MSD is an iterative “peel the thickest part first” technique. At each step, it finds the largest connected region of roughly uniform thickness, extracts it, removes it from the shape, and repeats on the residual. This process yields a thickness-ordered set of volumetric regions for primitive initialization.
即:MSD 是一种迭代式"先剥最厚部分"的技术。每一步它找出厚度大致均匀的最大连通区域,将其提取出来、从形状中移除,然后对残差重复上述过程。这样便得到一组按厚度排序的体积区域,用于图元的初始化。
分解感知优化(有了基元和Resfit之后如何优化)
优化不是孤立进行,优化目标为上文所描述的公式,同时最大化重建精度、最小化基元数量;
可微阶段用梯度下降平滑调整所有参数;离散剪枝阶段用贪心删除移除冗余基元。可微与离散的结合,是本文优化策略的重要特征——纯可微方法难以让基元数量"消失",纯离散方法无法精修参数,两者互补。
重建损失是可微代理,直接监督装配体的 occupancy 场与真值 occupancy 的一致性:
$$w(p) = 1 + \sigma(\kappa(p)), \quad \mathcal{L}_{rec} = \frac{1}{|\mathcal{M}|} \sum_{p \in \mathcal{M}} w(p)\big(\hat{o}(p) - o(p)\big)^2$$采样策略:在形状体内均匀采样、表面附近密集采样。这样既能保证整体体积形状正确,又能把采样资源集中在决定视觉质量的表面区域;
曲率加权:w(p)=1+σ(κ(p))w(p)=1+σ(κ(p)) 用 sigmoid 将主曲率映射到权重。高曲率区域(细杆、尖角、边缘)获得更大权重,迫使优化器优先保这些最容易被基元平滑掉的细节。这是针对"基元拟合常牺牲高频几何"这一痛点的直接回应;
空间掩码:损失只在 F(p)<τF(p)<τ 的区域内计算,即只考察当前装配体附近的空间。远处的点(真值在这里原本就为空)不会产生无关梯度,使优化信号集中在装配体实际占据的邻域,避免"远处空域"主导损失。
简洁损失:为了让装配体紧凑,论文引入了一种可微的基元存活机制。
机制可以拆解为三步:
每个基元 i 获得一个生存概率变量 qi,通过 Gumbel-Softmax 采样得到(保证可微);
基元的 SDF 被 qi 调制:当 qi 接近 1 时,基元正常存在;当 qi 接近 0 时,其 SDF 被推向一个很大的正常数,等效于"被擦除"(在隐式场上,大正距离意味着该位置被视为空);
损失中加入惩罚项 Lcount=∑iqi,直接惩罚期望的活跃基元数。(删除基元不是二值决策,而是可以根据优化得到的。)
质量损失:防止纠缠与过度混合,针对可编辑性,惩罚两类几何上的问题,
$$\mathcal{L}_{qual} = \underbrace{\max\big(1, \sum_i \hat{o}_i(p)\big)}_{\mathcal{L}_{overlap}} + \underbrace{\hat{o}(p) - \min\big(\sum_i \hat{o}_i(p), 1\big)}_{\mathcal{L}_{union}}$$可微优化收敛后,进入离散剪枝阶段:对每个体积或贡献可忽略的基元,尝试删除并重新评估目标 O(重建精度扣减基元数的惩罚项),只有删除后 O 提升才接受删除。这一步补足了可微阶段做不到的"硬删除",确保最终装配体在"精度-简洁"权衡上真正达到局部最优。
前提知识
SDF:符号距离场(Signed Distance Field)和零水平集合
SDF 是一个标量函数,它为空间中的每个点 pp 赋予一个带符号的数值,含义是"该点到某个形状表面的距离":
$$f(p) = \text{符号} \times \text{距离}$$在形状内部的时候值为0,以此类推。
零水平集就是空间中$f(p) = 0$的位置。
存在问题
ResFit 的组合方式只有并集(union)——所有基元通过平滑并集合成为最终形状,整个过程里没有减法。这带来两类后果:
打孔、挖槽类形状难以表达。例如一个带圆孔的平板、或内外侧轮廓不同的壳体,用"加"是加不出来的,需要"整体减掉一个圆柱"这类操作。虽然 SuperFrustum 的(onion operator)可以原生表达一些空心/管状形状(论文在 CSG 应用中也把它列入了规范形状列表),但这只是"内置的负形状",无法覆盖任意位置的任意减法;
CSG 应用中的潜在妥协。在第 5 节的 CSG 实验里,“solid” 版本需要靠参数约束来产生规范实体,恰好反映这一限制——真正的 CSG 程序应该有自由的加/减组合,而当前框架只能做加法程序。
可能后续
打孔、挖槽类形状难以表达:增加额外的空间锚点来辅助分形状分割。
无基元的ResFit。
语义分割增强(3d),手工标注零件昂贵,数据集常只有粗粒度标注,基元装配可以作为分割的先验。